AI가 만든 CSV 집계 코드, 실무에 쓰기 전 확인할 6가지
합성 CSV 13행과 정답 표로 AI가 만든 집계 코드를 검산합니다. 중복 거래·빈 금액·천 단위 쉼표·환불·반올림·원본 보존을 확인하는 Python 예제와 자동 테스트를 제공합니다.
이 글의 목차
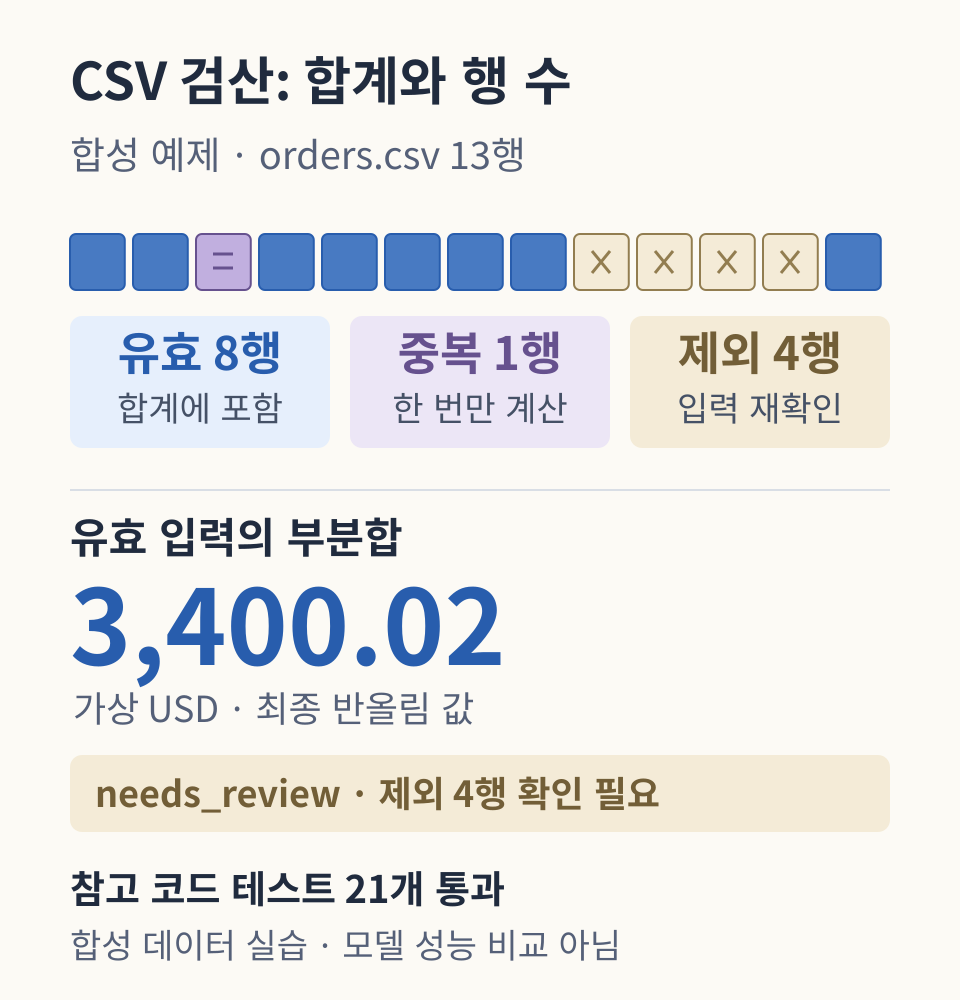
AI가 만든 CSV 집계 코드는 합계뿐 아니라 빠진 행, 중복 처리, 반올림 시점까지 확인해야 합니다. 작은 시험 파일의 정답을 먼저 정하고, 코드가 그 값과 제외 사유를 함께 내는지 비교하면 됩니다. 아래 13행 예제의 유효 금액 합계는 3,400.02입니다. 다만 잘못된 입력 4행을 제외한 부분합이므로, 그대로 업무의 확정 총액으로 쓰면 안 됩니다.
이 글은 일부러 만든 합성 CSV를 Python으로 실행해 확인한 실습입니다. 특정 AI 모델의 답변을 평가하거나 실제 고객 자료를 분석한 결과는 아닙니다. 같은 파일을 자신의 코드에 넣어 검산할 수 있도록 CSV·참고 코드·테스트 묶음을 함께 제공합니다.
먼저 정답과 처리 규칙을 정합니다
예제에는 event_id, category, amount 세 열이 있습니다. 금액은 하나의 통화로 된 가상 USD 중간 계산값이라고 가정합니다. 환율, 세금, 실제 결제 처리는 다루지 않습니다.
이 파일의 규칙은 다음과 같습니다.
- 같은 거래 이벤트 ID가 같은 내용으로 반복되면 한 번만 더합니다. 같은 ID의 내용이 다르면 집계를 중단합니다.
- 금액이 비었거나 정한 숫자 형식에 맞지 않으면 제외하고 이유를 남깁니다.
0은 정상 금액입니다. - 음수는 환불로 보고 그대로 더합니다. 환불 이벤트는 원거래와 다른 ID를 씁니다.
- 소수를 유지해 더한 뒤 마지막에 소수 둘째 자리까지
ROUND_HALF_UP으로 반올림합니다.
이 규칙은 실습을 위한 선택입니다. 실제 업무가 행별 반올림이나 다른 중복 기준을 쓴다면 정답부터 바꿔야 합니다.
orders.csv의 전체 내용입니다. 쉼표가 들어간 금액의 큰따옴표도 복사해야 합니다.
event_id,category,amount
T001,A,"1,200.50"
T002,A,299.50
T002,A,299.50
T003,A,-100.00
T004,B,0.005
T005,B,0.005
T006,B,0.005
T007,B,0
T008,B,
T009,B,oops
T010,B,NaN
T011,B,"12,34"
T012,C,"2,000"| 구분 | 합계에 넣는 행 수 | 반올림 전 합계 | 최종 표시값 |
|---|---|---|---|
| A | 3 | 1400.00 | 1400.00 |
| B | 4 | 0.015 | 0.02 |
| C | 1 | 2000 | 2000.00 |
| 전체 | 8 | 3400.015 | 3400.02 |
행 수는 전체 13행 = 유효 8행 + 중복 1행 + 제외 4행이어야 합니다. 여기서 행 번호는 헤더를 빼고 센 데이터 레코드 순서입니다. 3번이 중복이고, 9~12번이 제외됩니다.
1. 쉼표가 들어간 금액을 한 칸으로 읽나요
"1,200.50"을 쉼표마다 잘라 버리면 1과 200.50 두 칸이 됩니다. CSV는 단순히 split(",")로 나누지 말고 CSV 파서로 읽습니다. Python의 csv.reader는 필드를 문자열로 반환하므로 금액 변환 규칙은 별도로 정해야 합니다. 파일을 열 때는 newline=""을 지정합니다. (Python csv 문서)
with path.open(encoding="utf-8-sig", newline="") as handle:
    reader = csv.reader(handle, strict=True)
예제는 UTF-8 파일과 UTF-8 BOM이 있는 파일을 받습니다. utf-8-sig는 읽을 때 파일 첫머리의 BOM을 처리합니다. CP949 같은 다른 인코딩을 자동으로 알아맞히는 설정은 아닙니다. (Python utf-8-sig 문서)
쉼표를 없애는 것만으로도 부족합니다. 12,34를 무조건 1234로 바꾸면 잘못된 표기를 정상 금액으로 받아들이게 됩니다. 이 예제는 세 자리씩 묶인 쉼표만 허용하고, 헤더와 열 개수도 검사합니다.
2. 빈 금액과 0을 구분하나요
T007의 0은 유효합니다. T008의 빈칸은 금액을 모르는 상태라 제외해야 합니다. 둘 다 0으로 바꾸면 합계만 봐서는 누락을 알아채기 어렵습니다.
제외 결과도 정답에 포함합니다.
| 데이터 행 | 입력 금액 | 제외 사유 |
|---|---|---|
| 9 | 빈칸 | blank_amount |
| 10 | oops |
invalid_amount |
| 11 | NaN |
invalid_amount |
| 12 | 12,34 |
invalid_amount |
Decimal로 바꾸기만 하면 검증이 끝나는 것도 아닙니다. Decimal은 NaN, Infinity 같은 특수값을 표현할 수 있습니다. 예제는 숫자 형태를 먼저 제한해 이런 값을 받지 않습니다. (Python Decimal 문서)
실행 결과는 status: needs_review와 제외 사유를 함께 냅니다. 종료 코드도 1로 둬서, 잘못된 입력이 있는 부분합이 자동화의 성공 결과로 넘어가지 않게 했습니다. 제외 행을 고치거나 제외 이유를 확인하기 전에는 다음 업무 단계로 넘기지 않습니다.
3. 중복을 무엇으로 판단하나요
예제의 T002는 ID·분류·금액이 모두 같아 두 번째 항목을 중복으로 기록합니다. A의 합계는 1,200.50 + 299.50 − 100.00 = 1,400.00입니다. 중복을 두 번 더하면 1,699.50이 됩니다.
하지만 같은 ID의 금액이 바뀌었다면 먼저 나온 값이나 마지막 값을 임의로 고르면 안 됩니다. 다음 입력은 합계를 출력하지 않고 오류로 중단하도록 정했습니다.
event_id,category,amount
T001,A,100
T001,A,110
참고 코드의 중복 기준은 양끝 공백을 제거한 뒤 세 값의 원문이 같은지입니다. 따라서 100과 100.00도 같은 ID로 들어오면 충돌입니다. 숫자로는 같아도 원본 기록이 달라졌으므로 사람이 확인하게 하는 보수적인 규칙입니다.
주문 번호와 거래 이벤트 번호도 구분해야 합니다. 한 주문에 분할 결제나 여러 번의 환불이 생길 수 있다면 주문 번호만으로 중복을 지워서는 안 됩니다. 원본 시스템에서 각 거래를 구분하는 키부터 확인합니다.
4. 환불의 마이너스 부호를 유지하나요
T003의 -100.00을 그대로 더해야 A가 1,400.00이 됩니다. 음수를 제외하면 1,500.00, 절댓값으로 바꾸면 1,600.00입니다. 중복 처리는 같아도 환불 규칙 하나로 결과가 달라집니다.
이 실습은 별도 상태 열 없이 음수 금액으로 환불을 표현합니다. 실제 파일이 status=refunded에 양수 금액을 넣는 방식이라면 이 코드를 그대로 쓰지 말고 부호를 결정하는 규칙을 새로 정해야 합니다.
5. 반올림은 언제 하나요
B에는 0.005가 세 번 들어 있습니다. 이 글의 규칙대로 먼저 합하면 0.015이고, 마지막에 한 번 반올림하면 0.02입니다. 각 행을 먼저 0.01로 반올림한 뒤 더하면 0.03이 됩니다.
참고 코드는 입력 문자열을 바로 Decimal로 변환합니다. float를 거치면 원래 십진수와 다른 이진 부동소수점 근삿값이 들어갈 수 있습니다. (Python 부동소수점 설명)
반올림은 코드에 명시합니다. ROUND_HALF_UP은 가장 가까운 값으로 반올림하되 정확히 중간이면 0에서 멀어지는 쪽을 고릅니다. 소수 둘째 자리 기준으로 0.005는 0.01, -0.005는 -0.01입니다. (Python 반올림 모드)
from decimal import Decimal, ROUND_HALF_UP

total = sum((Decimal("0.005") for _ in range(3)), Decimal("0"))
print(total.quantize(Decimal("0.01"), rounding=ROUND_HALF_UP))
# 0.02
카테고리별 표시값과 전체 표시값을 계산하는 순서도 정합니다. 예를 들어 A와 B에 각각 0.005가 있으면 표시값은 각각 0.01이라 둘을 더하면 0.02입니다. 원금액의 전체 합계는 0.010이므로 전체를 한 번 반올림하면 0.01입니다. 어느 쪽을 보고서 총액으로 쓸지 정하지 않으면 서로 다른 집계를 비교하게 됩니다.
6. 원본이 그대로이고 다시 돌려도 같은가요
참고 프로그램은 입력 CSV를 읽고 결과를 터미널에만 출력합니다. 테스트는 실행 전후 CSV의 바이트가 같은지, 같은 파일을 두 번 처리했을 때 결과가 같은지 확인합니다.
자신의 자동화가 결과 파일을 만든다면 같은 검사를 추가합니다. 원본에 결과를 덮어쓰거나, 다시 실행할 때 이전 결과에 계속 더하는지 확인해야 합니다. 출력 파일명만 달라도 충분한 것은 아닙니다. 파일을 지우거나 바깥으로 보내는 코드가 없는지 먼저 읽어 봅니다.
시험 데이터에는 개인정보와 API 키를 넣지 않습니다. 처음 받은 코드는 개인 파일·자격 증명·네트워크에 접근하지 못하는 별도 테스트 환경에서 확인합니다. 테스트 통과는 코드가 안전하다는 증명까지 해 주지는 않습니다.
예제를 실행하고 내 코드에 적용합니다
예제 ZIP을 풀면 입력 CSV, 수기로 정한 expected.json, 참고 구현 csv_check.py, 자동 테스트 test_csv_check.py가 들어 있습니다. 추가 패키지는 필요하지 않습니다. Python 3.12가 있는 환경에서 압축을 푼 폴더로 이동해 실행합니다.
python3 -m unittest -v test_csv_check.py
python3 csv_check.py fixtures/orders.csv
python3 csv_check.py fixtures/conflicting-id.csv
이 글을 준비하며 Linux x86_64 클라우드 환경의 CPython 3.12.14에서 21개 테스트가 통과했습니다. orders.csv는 위 정답 표와 일치했고, 충돌 ID 파일은 합계를 내보내지 않았습니다. UTF-8 BOM, 잘못된 헤더·열 수, NaN, 음수, 반올림 시점, 원본 보존도 검사했습니다. 이 확인은 2026년 10월 3일 UTC에 했으며 Windows 실행과 실제 업무 파일은 시험하지 않았습니다. 전체 실행 기록과 환경 정보는 ZIP에 포함했습니다.
예제의 종료 코드는 다음과 같습니다.
- 0: 잘못된 입력으로 제외한 행 없이 검사를 마쳤습니다. 같은 내용의 중복만 있는 경우도 0이며, 중복 위치는 결과에 남깁니다.
- 1: 제외 행이 있어 유효 입력의 부분합만 출력했습니다.
orders.csv의 예상 결과입니다. - 2: 구조 오류나 충돌 ID 등이 있어 합계를 출력하지 않았습니다.
conflicting-id.csv의 예상 결과입니다.
첫 명령의 자동 테스트는 함께 제공한 참고 구현을 검사합니다. 다른 AI가 만든 코드까지 자동으로 검사한 것은 아닙니다. 자신의 코드에 같은 CSV를 넣고 금액, 유효 건수, 중복 위치, 제외 사유를 정답과 비교합니다. 테스트를 그대로 재사용하려면 ZIP의 README에 적힌 함수·출력 형식을 유지해야 합니다. unittest 실행법은 Python 공식 문서에서도 확인할 수 있습니다.
AI에게 수정을 맡길 때는 다음처럼 요청할 수 있습니다.
이 CSV의 집계 코드를 수정해줘.
정답은 전체 13행, 유효 8행, 중복 1행, 제외 4행이다.
A는 1400.00, B는 반올림 전 0.015·후 0.02, C는 2000.00이다.
전체 원금액 합계는 3400.015, 최종 표시값은 3400.02다.

첨부한 처리 규칙과 expected.json, 테스트 파일은 바꾸지 마.
빈칸을 0으로 채우지 말고 제외 위치와 이유를 남겨줘.
같은 거래 이벤트 ID의 내용이 다르면 합계를 내보내지 마.
원본 CSV는 수정하지 말고, 바꾼 코드와 실제 실행 결과를 보여줘.
이 예제를 넘어서는 데이터라면
다운로드 코드는 학습용으로 범위를 제한했습니다. 쉼표 구분 UTF-8 CSV, 데이터 최대 10,000행, 금액의 정수 최대 12자리·소수 최대 6자리만 받습니다. 1.234,56 같은 다른 지역 표기, 여러 통화, 취소 상태, 환율, 날짜·시간대, 대용량 파일은 별도 규칙과 테스트가 필요합니다.
먼저 자기 업무에서 자주 생기는 예외를 하나 추가하고 정답을 직접 계산해 두세요. 코드가 바뀔 때 같은 시험 파일을 다시 돌리면 됩니다. 테스트를 통과시키려고 정답 파일을 코드 출력으로 덮어쓰면 비교 기준을 잃게 됩니다.
검산 절차를 반복해서 쓰는 방법은 Hermes Agent의 Skills·Memory 구분에서 이어서 볼 수 있습니다.
함께 보면 좋은 글
AI 코딩 도구 전체 보기 →
Hermes Agent Skills·Memory 차이: 저장할 내용·경로·변경 승인
Hermes Agent의 MEMORY.md·USER.md와 Skills에 둘 내용을 구분하고, 저장 위치와 변경 승인 명령을 CSV 검산 예시로 설명한다.
GitHub Copilot /btw 사용법: VS Code 옆 질문과 검토
GitHub Copilot /btw 사용법과 VS Code Agents 창에서 옆 질문을 분리하는 순서를 안내한다. Agent Plugins, 브라우저 주석, 받아쓰기 설정과 기능별 확인 항목도 다룬다.
Hermes Agent 설치·Provider 설정: Windows·WSL2부터 첫 응답까지
Hermes Agent를 Windows·WSL2에 설치하고 Provider를 연결하는 순서다. OAuth·API 키 저장 위치, 로컬 Ollama 조건, 첫 응답 확인과 기본 보안 설정을 정리한다.
첫 댓글을 남겨 보세요.
로그인은 계정 확인에만 사용하며 이메일 원문은 저장하거나 공개하지 않습니다.
댓글은 공개됩니다. 개인정보·광고·비방성 내용은 남기지 마세요. 운영 기준은이용 안내에서 확인할 수 있습니다.