GPT-6.1 Sol 성능 비교: Sol·Astra 대신 쓸 만할까?
GPT-6.1 Sol을 기존 Sol·Astra·Claude와 독립 벤치마크로 비교했다. 추론 설정별 점수와 과제당 비용, 공식 평가의 한계, ChatGPT Work·Codex에서 바꿔 볼 기준을 설명한다.
핵심 요약
- 독립 평가의 max 설정에서 GPT-6.1 Sol은 기존 Sol보다 높은 종합점수와 낮은 과제당 비용을 보였다.
- Astra·Claude보다 무조건 낫다는 결론은 아니다. 추론 설정과 작업 종류에 따라 선택할 이유를 나눴다.
- API 단가와 ChatGPT 구독 사용량은 별개다. 평가 비용을 구독에서 가능한 작업 수로 환산하지 않는다.
- 이 글은 공개 평가와 공식 조건을 비교한 안내다. 한국어 실무 품질이나 ChatGPT 구독 한도를 직접 측정한 결과는 아니다.
이 글의 목차
GPT-6 Sol의 작업 완성도가 아쉬웠다면 GPT-6.1 Sol을 비교해 볼 근거가 있다. 9월 30일 독립 평가에서 max 설정의 종합점수가 높아졌고 과제당 비용은 낮아졌다. 비용을 줄이려는 Astra 사용자도 시험할 후보지만, 모든 작업을 대체할 수 있는지는 따로 봐야 한다. 아래는 현재 공개된 평가로 내릴 수 있는 판단이다. (Artificial Analysis)
기존 모델 중 어느 정도인가
독립 평가 기관 Artificial Analysis의 Intelligence Index v4.3.2는 업무·코딩·과학 추론 등을 묶은 종합지수다. 주로 영어·텍스트 평가이므로 한국어 글쓰기 순위로 읽으면 안 된다. (평가 방법)
2026년 9월 30일 확인한 비교 대상의 값이다. 점수는 높을수록 좋다.
| 모델·추론 설정 | 종합지수 | 평가 과제당 비용 |
|---|---|---|
| Claude Opus 5.5 · max with fallback | 58 | $5.98 |
| Claude Sonnet 5.5 · max with fallback | 56 | $7.60 |
| GPT-6 Astra · max | 53 | $3.26 |
| GPT-6.1 Sol · max | 52 | $0.72 |
| GPT-6 Sol · max | 48 | $1.05 |
| GPT-6.1 Sol · medium | 48 | $0.21 |
(AA 리더보드)
6.1 Sol max는 기존 Sol max보다 4점 높고 비용은 약 31% 낮다. Astra와는 1점 차이다. 이 표에서 6.1 Sol의 매력은 높은 종합점수에 비해 낮은 평가 비용이다. Claude 두 모델은 더 높은 점수와 더 높은 비용을 함께 보였다. 서로 다른 회사의 max·fallback 설정을 같은 계산량으로 간주하면 안 된다.
비용은 AA 평가에서 소비한 토큰과 가격을 반영한 가중 평균이다. 독자의 요청 한 건 가격이나 ChatGPT에서 할 수 있는 작업 수가 아니다. (비용 계산 방법)
추론을 무조건 max로 올려야 할까
6.1 Sol은 medium에서 48점·$0.21, max에서 52점·$0.72다. 공개 수치로 계산하면 4점 상승에 과제당 비용이 약 3.4배다. medium이 기존 Sol max와 같은 종합점수여도 개별 문제의 결과까지 같다는 뜻은 아니다. (AA 리더보드)
따라서 익숙한 작업을 기본 설정으로 먼저 돌리고, 빠진 조건이나 실패가 있을 때 강도를 높여 비교하는 방식을 권한다. OpenAI도 기본 설정에서 시작해 작업에 따라 조정하도록 안내한다. 높은 추론 강도는 시간과 토큰을 더 쓸 수 있다. (모델·추론 설정)
코딩·컴퓨터 작업에서는 무엇이 달라졌나
아래는 OpenAI가 발표한 평가다. 위의 AA 독립 평가와 시험 구성이 다르므로 점수를 합쳐 순위를 만들지 않는다.
| 평가 대상 | OpenAI가 밝힌 결과 | 선택할 때의 의미 |
|---|---|---|
| 실제 저장소의 긴 코딩 작업, DeepSWE v1.1 | 기존 Sol 최고점보다 6.4%포인트 높음. 더 낮은 추론 강도·비용에서 얻은 결과 | 기존 Sol이 막히던 복잡한 수정 작업을 비교해 볼 근거 |
| 앱을 오가는 컴퓨터 작업, OSWorld 2.0 오프라인 세트 | 최대 추론 강도에서 기존 Sol보다 7%포인트 높고 비용은 절반 미만 | 여러 단계를 수행하는 작업의 후보. 특정 Windows 오류를 해결했다는 증거는 아님 |
과학 연구 작업을 다룬 Terminal-Bench Science 0.1에서는 Astra가 68.1%로 최고점이었다. OpenAI는 연구 환경·API와 실제 ChatGPT가 시스템 지시·도구·추론 설정 때문에 다른 결과를 낼 수 있다고 설명한다. (발표와 평가 조건)
이 결과만으로 한국어 문장 품질, 내 코드베이스의 수정 성공률, 보고서의 완성도를 확정할 수는 없다. 자기 작업의 정답·실패 조건으로 후보를 좁히는 자료로 쓰는 것이 맞다.
가격이 같아도 실제 비용은 달라진다
API 표준 단가는 100만 토큰당 입력 $2·출력 $10으로 기존 Sol과 같다. 캐시된 입력만 $0.2에서 $0.1로 줄었다. 여러 요청에서 합계 100만 토큰이 캐시에서 재사용된다면 해당 캐시 입력 비용의 차이는 $0.10이다. 출력 등 다른 비용까지 절반이 되는 계산은 아니다. (6.1 Sol, 기존 Sol)
이 계산은 표준 처리·요청당 입력 27만 2천 토큰 이하의 단가 기준이다. 더 긴 입력, Fast, Batch·Flex 등은 요율이 다르다. API에서 바꿀 때는 none 추론과 Chat Completions의 도구 호출을 지원하지 않는 차이도 확인해야 한다. (모델 조건)
ChatGPT Work·Codex 구독 사용량은 API 달러 단가와 별개다. 포함 사용량과 추가 크레딧도 구분해야 하므로, API 비용이 낮다는 이유로 구독에서 작업을 몇 배 더 할 수 있다고 계산하지 않는다. (구독 사용량 안내)
바꿔 볼 사람과 기존 모델을 유지할 사람
공개 근거를 바탕으로 다음처럼 선택하는 것을 권한다.
- 기존 Sol로 긴 코딩·문서 작업을 하는 사람: 6.1 Sol에 같은 입력·자료·완료 조건을 주고 비교한다. 최종 결과뿐 아니라 다시 지시한 횟수와 사람이 고친 시간도 본다.
- Astra의 비용·사용량이 부담인 사람: 반복 작업 일부를 6.1 Sol로 비교하되, 결과의 오류나 수정 부담이 늘면 그 작업은 Astra에 남긴다.
- 한국어 문체나 특정 업무에서 기존 모델에 만족하는 사람: 종합지수만으로 옮길 필요는 없다. 평소 결과물과 비교해 바꿀 이유가 확인될 때 전환한다.
작은 비교를 할 때는 먼저 성공 기준을 적는다. 코드라면 기존 테스트와 요청 범위, 문서라면 빠뜨리면 안 되는 사실·수치·형식을 정한다. 결과를 본 뒤 유리한 기준을 골라 붙이지 않는다. 이 글에는 Techies Note가 두 모델의 작업 품질을 직접 비교한 실험은 포함하지 않았다.
9월 30일 공식 안내상 Plus·Pro·Business·Enterprise·Edu의 Work·Codex에서 제공되며 일반 Chat에는 없다. Enterprise·Edu는 관리자 활성화가 필요하다. 앱에서는 Advanced에서 모델을 선택하고, CLI에서는 codex -m gpt-6.1-sol로 지정한다. (제공 범위와 선택 방법)
모델이 안 보이면 계정·클라이언트의 제공 범위부터 확인한다. 이날 아침 이 PC의 옛 CLI에서는 모델 지원 오류로 답을 받지 못했다. 이는 접속 관찰이며 성능 비교가 아니다. 사용 가능한 모델을 고르는 방법은 ChatGPT Codex 설치·사용법: 앱·CLI 선택과 첫 프로젝트에서 이어서 볼 수 있다.
함께 보면 좋은 글
ChatGPT 전체 보기 →
ChatGPT Codex 설치·사용법: 앱·CLI 선택과 첫 프로젝트
ChatGPT Codex 사용법을 앱·CLI·IDE·클라우드별로 살펴본다. Windows CLI 설치와 로그인, 첫 프로젝트 요청, 실행 위치 선택, 변경 결과를 확인하는 순서를 정리한다.
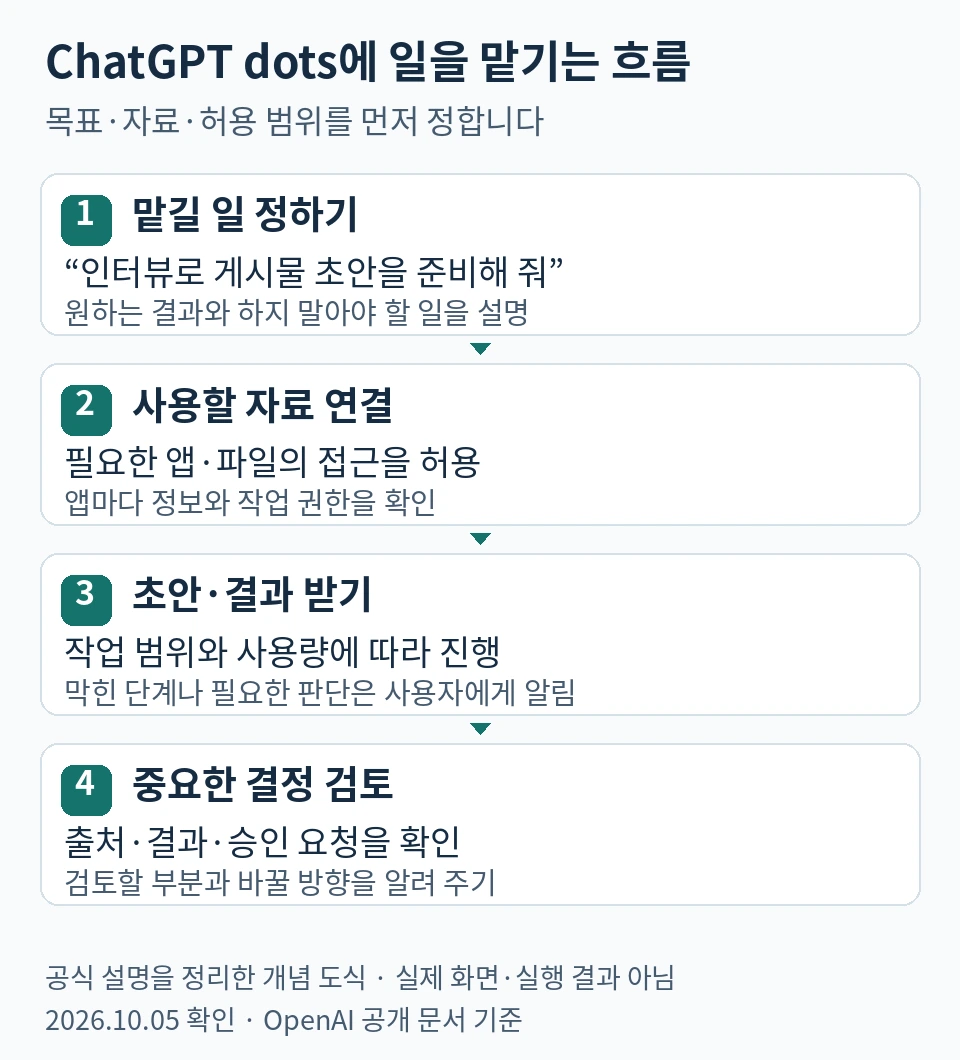
ChatGPT dots란? 맡길 수 있는 일과 비용·이용 조건
ChatGPT dots가 무엇인지, 어떤 사람에게 유용한지 공식 업무 예시 3가지로 설명합니다. 일반 대화와의 차이, 승인과 사용량 한계, 한국·Pro·모바일 이용 조건을 정리합니다.
챗지피티(ChatGPT) 무료 사용법: 한도·유료 차이와 무료 혜택
챗지피티(ChatGPT)를 웹·앱에서 무료로 시작하는 법과 로그인 없이 쓰는 조건을 정리했다. 무료 모델·파일·이미지·음성 한도, 한도에 걸렸을 때의 조치와 카카오 Plus 무료 혜택까지 확인한다.
첫 댓글을 남겨 보세요.
로그인은 계정 확인에만 사용하며 이메일 원문은 저장하거나 공개하지 않습니다.
댓글은 공개됩니다. 개인정보·광고·비방성 내용은 남기지 마세요. 운영 기준은이용 안내에서 확인할 수 있습니다.